29 Mar 2026
Il lavoro di TurboQuant di Google merita attenzione, ma non per le solite ragioni "l'IA ha appena cambiato tutto".
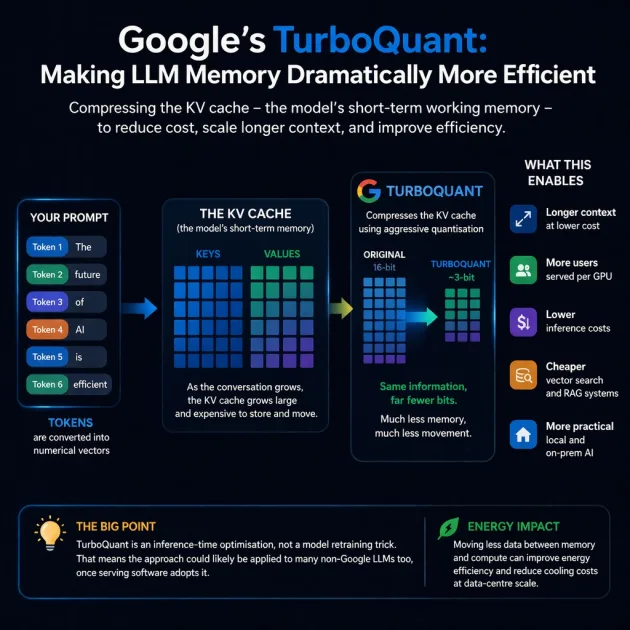
Perché è importante
Negli ultimi post ho parlato di token, vettori e finestre di contesto e di come questi influenzino il modo in cui gli LLM lavorano. TurboQuant si trova proprio all'intersezione di tutti e tre.
L'idea è in realtà piuttosto semplice.
Quando si digita un prompt, il modello non si limita a leggerlo una volta sola. Memorizza una rappresentazione numerica di ciò che è stato digitato come token in una cache KV (Key-Value). Questa funge da memoria di lavoro a breve termine del modello.
Man mano che il contesto cresce, cresce anche la cache e il costo della memorizzazione e dello spostamento diventa un serio collo di bottiglia.
TurboQuant si occupa di comprimere questa memoria in modo molto più aggressivo, preservando al contempo le prestazioni del modello.
Cosa non è TurboQuant
Non si tratta di calcolo "quantistico".
Si tratta di quantizzazione. In altre parole, si tratta di memorizzare i dati di lavoro del modello utilizzando meno bit.
La vera storia non è l'"intelligenza artificiale quantistica". È che Google potrebbe aver trovato un modo intelligente per ottenere una compressione estrema senza distruggere i risultati.
Perché potrebbe essere importante
Se questo dato è valido anche al di fuori dei benchmark di Google, le implicazioni sono piuttosto significative:
- Un contesto più lungo diventa più economico
- Più utenti possono essere serviti per GPU
- I costi di inferenza** potrebbero diminuire
- Anche la ricerca vettoriale e i sistemi RAG** potrebbero diventare più economici.
- L'IA** locale e on-premise diventa più realistica e conveniente
La parte più interessante è che questa non sembra essere un'idea esclusiva di Google.
Trattandosi di una ottimizzazione del tempo di inferenza piuttosto che di un trucco di riqualificazione specifico del modello, lo stesso approccio generale potrebbe essere applicato anche a molti LLM non Google, sempre che il software di servizio si metta al passo.
Un utile benchmark
Un buon test per un algoritmo di compressione è il benchmark Needle-in-a-Haystack, che valuta se un'intelligenza artificiale è in grado di trovare una singola frase specifica nascosta in 100.000 parole, ovvero circa 130.000 token.
Nei test condotti su modelli open-source come Lama-3.1-8B e Mistral-7B, TurboQuant ha ottenuto punteggi di richiamo perfetti, eguagliando le prestazioni dei modelli non compressi e riducendo al contempo l'ingombro della memoria cache KV di almeno 6 volte.
Il quadro generale
Poiché riduce la quantità di dati che devono essere spostati durante l'inferenza, potrebbe anche migliorare l'efficienza energetica.
Su scala di data center, anche i guadagni più modesti sono importanti sia per la elettricità che per il raffreddamento.
Tradotto con DeepL.
Vuoi applicare queste idee alla tua azienda?
Se questo articolo ha sollevato una domanda utile, parliamo di dove AI, automazione o strategia di prodotto possono creare leva concreta nella tua organizzazione.
Avvia la conversazione