29 Mar 2026
Die Arbeit von Google an TurboQuant ist es wert, beachtet zu werden, aber nicht aus den üblichen "KI hat gerade alles verändert"-Gründen.
Warum das wichtig ist
In den letzten Beiträgen habe ich über Tokens, Vektoren und Kontextfenster gesprochen und darüber, wie sie die Arbeitsweise von LLMs beeinflussen. TurboQuant befindet sich genau an der Schnittstelle aller drei.
Die Idee ist eigentlich ziemlich einfach.
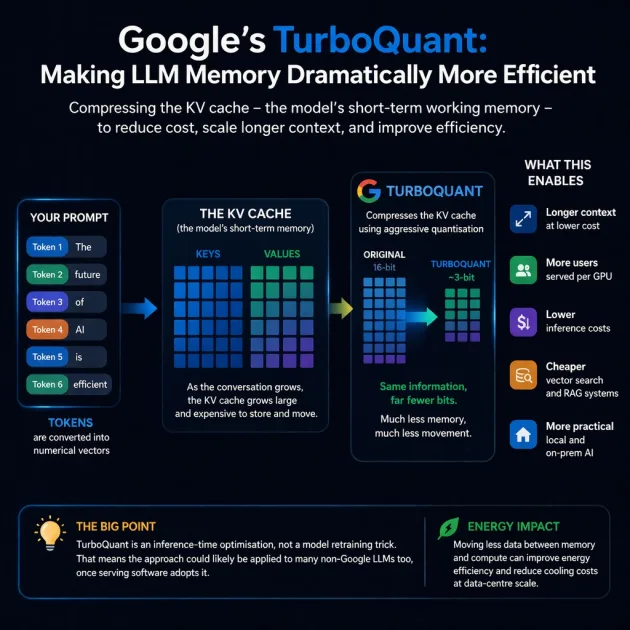
Wenn Sie eine Eingabeaufforderung eingeben, liest das Modell diese nicht nur einmal. Es speichert eine numerische Darstellung dessen, was Sie getippt haben, als Token in einem Key-Value (KV)-Cache. Dieser fungiert als Kurzzeit-Arbeitsspeicher des Modells.
Wenn der Kontext wächst, wächst auch der Cache, und die Kosten für das Speichern und Verschieben werden zu einem ernsthaften Engpass.
Bei TurboQuant geht es darum, diesen Speicher viel aggressiver zu komprimieren, während die Modellleistung weitgehend erhalten bleibt.
*# Was TurboQuant nicht ist
Dies ist nicht "Quanten"-Rechnen.
Es handelt sich um Quantisierung. Mit anderen Worten, es geht darum, die Arbeitsdaten des Modells mit weniger Bits zu speichern.
Die wahre Geschichte ist nicht die "Quanten-KI". Es geht darum, dass Google möglicherweise einen cleveren Weg gefunden hat, um eine extreme Komprimierung zu erreichen, ohne die Ergebnisse zu zerstören.
Warum das wichtig sein könnte
Wenn dies auch außerhalb der Google-eigenen Benchmarks zutrifft, sind die Auswirkungen ziemlich bedeutend:
- Längerer Kontext wird billiger
- Mehr Nutzer können pro GPU bedient werden
- Inferenzkosten könnten sinken
- Vektorsuche und RAG-Systeme könnten ebenfalls billiger werden
- Lokale und vor Ort installierte KI** wird realistischer und erschwinglicher
Das Interessanteste daran ist, dass es sich hierbei offenbar nicht um eine Idee handelt, die nur von Google stammt.
Da es sich um eine Optimierung der Inferenzzeit und nicht um einen modellspezifischen Umschulungstrick handelt, könnte derselbe allgemeine Ansatz wahrscheinlich auch auf viele LLMs anderer Anbieter angewandt werden, vorausgesetzt, die Serversoftware holt auf.
Ein nützlicher Benchmark
Ein guter Test für einen Komprimierungsalgorithmus ist der Needle-in-a-Haystack-Benchmark, der bewertet, ob eine KI einen einzigen bestimmten Satz finden kann, der in 100.000 Wörtern oder etwa 130.000 Token versteckt ist.
Bei Tests mit Open-Source-Modellen wie Llama-3.1-8B und Mistral-7B erzielte TurboQuant perfekte Wiedererkennungswerte, die mit der Leistung unkomprimierter Modelle übereinstimmen und gleichzeitig den KV-Cache-Speicherbedarf um mindestens das 6-fache reduzieren.
Das Gesamtbild
Da die Menge der Daten, die während der Inferenz bewegt werden müssen, reduziert wird, könnte auch die Energieeffizienz verbessert werden.
Im Maßstab eines Rechenzentrums sind selbst bescheidene Verbesserungen sowohl für den Stromverbrauch als auch für die Kühlung von Bedeutung.
Übersetzt mit DeepL.
Möchten Sie das auf Ihr Unternehmen anwenden?
Wenn dieser Beitrag eine gute Frage ausgelöst hat, sprechen wir darüber, wo KI, Automatisierung oder Produktstrategie in Ihrer Organisation praktischen Hebel schaffen können.
Gespräch starten