18 May 2026
Perché tutti gli addetti ai lavori dell'AI continuano a parlare di calcolo, e cosa significa in realtà per la vostra azienda
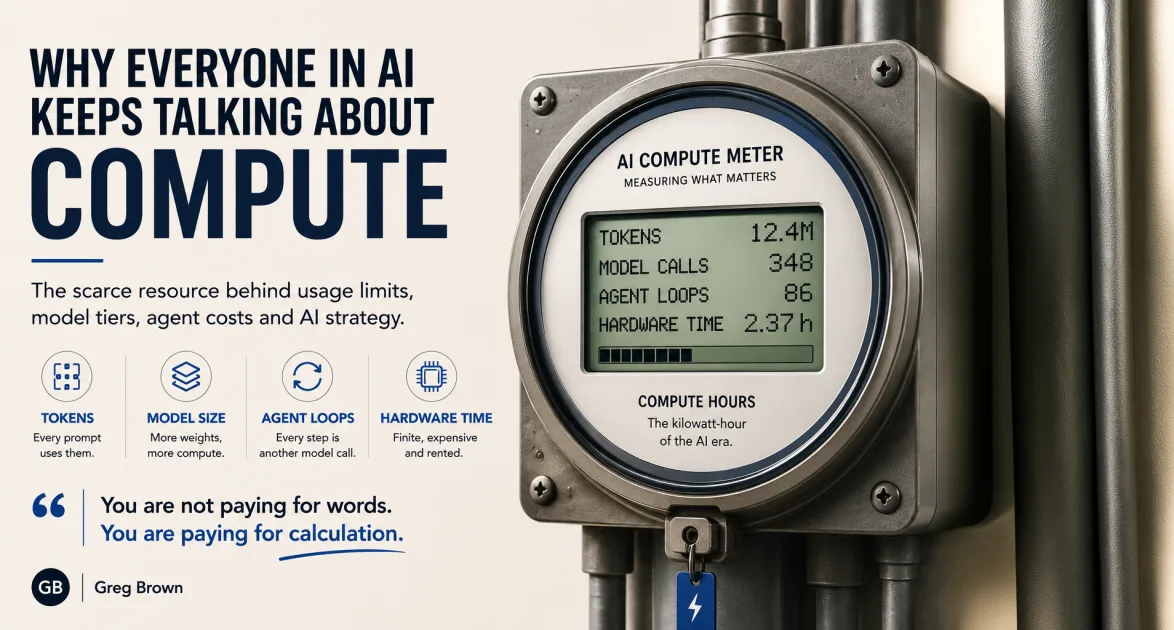
Comprendere il calcolo dell'intelligenza artificiale: Perché la vostra bolletta funziona come funziona
Il vostro limite di utilizzo si è ridotto questo mese, e poi potrebbe essere aumentato di nuovo. Il modello di ragionamento costa cinque volte di più di quello veloce. Gli agenti gestiti hanno un prezzo per sessione-ora piuttosto che per token. Niente di tutto questo è arbitrario. Tutto si riconduce alla stessa cosa: il calcolo.
Se avete trascorso un po' di tempo nell'ambito dell'intelligenza artificiale negli ultimi due anni, avrete sentito la parola "calcolo" pronunciata in modo tale da far pensare che spieghi tutto. È quasi così. Una volta capito come funziona il calcolo come risorsa, molti comportamenti confusi del mercato acquistano improvvisamente senso, compresa la maggior parte di ciò che sentite sulla vostra bolletta AI.
Ecco l'intera questione in termini chiari e cosa significa per le decisioni che i proprietari di PMI devono prendere quest'anno.
Che cos'è in realtà il "calcolo"
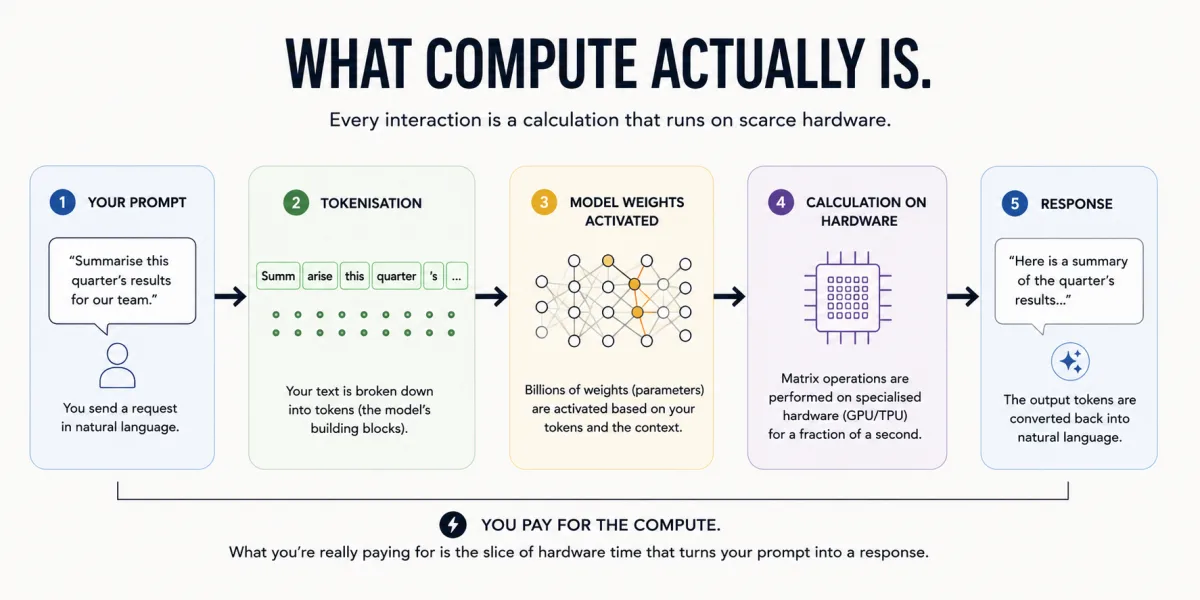
Ogni interazione con un modello di intelligenza artificiale è un calcolo. Un calcolo molto grande, che coinvolge miliardi di pesi, viene eseguito su hardware specializzato ottimizzato per il tipo di matematica parallela che le reti neurali richiedono. Questo hardware è finito, costoso e affittato al secondo.
Una parola sui pesi. Pensate a un modello come a miliardi di piccoli quadranti, ognuno dei quali viene regolato durante l'addestramento per codificare ciò che il modello ha imparato. Un modello da "70 miliardi di parametri" ha esattamente quel numero di quadranti. Ogni richiesta passa attraverso di essi, ed è per questo che i modelli più grandi richiedono più calcoli.
Quando inviate un messaggio a Claude, ChatGPT o Gemini, non state pagando per le parole. State pagando per la fetta di calcolo che trasforma le vostre parole in una risposta. I gettoni sono il modo in cui l'elaborazione viene misurata e fatturata, ma la risorsa scarsa sottostante è il tempo hardware stesso.
L'analogia quotidiana più vicina è l'elettricità. Non si paga per "avere le luci". Si paga per i chilowattora consumati. Il calcolo è il chilowattora dell'era dell'intelligenza artificiale.
Perché alcune query costano molto più di altre?
Non tutti i calcoli vengono spesi allo stesso modo. Un modello veloce che riassume un'email brucia una piccola fetta. Un modello di ragionamento che lavora su un problema a più fasi può consumare da cinquanta a cento volte di più, perché sta effettivamente parlando con se stesso tra la richiesta e la risposta.
Questo è il motivo per cui tutti i principali fornitori hanno ora dei livelli. Haiku, Sonnet, Opus. Flash, Pro. mini, standard, reasoning. I modelli economici sono economici perché sono più piccoli (meno pesi da calcolare) o eseguono un singolo passaggio prima di rispondere. Quelli costosi pensano prima di parlare, e pensare costa calcolo.
L'implicazione pratica è quella a cui continuo a tornare: non usate un modello di ragionamento per riassumere una nota di riunione. State pagando il prezzo di un modello di frontiera per un lavoro veloce. Abbinate il modello al lavoro.
Il moltiplicatore di agenti
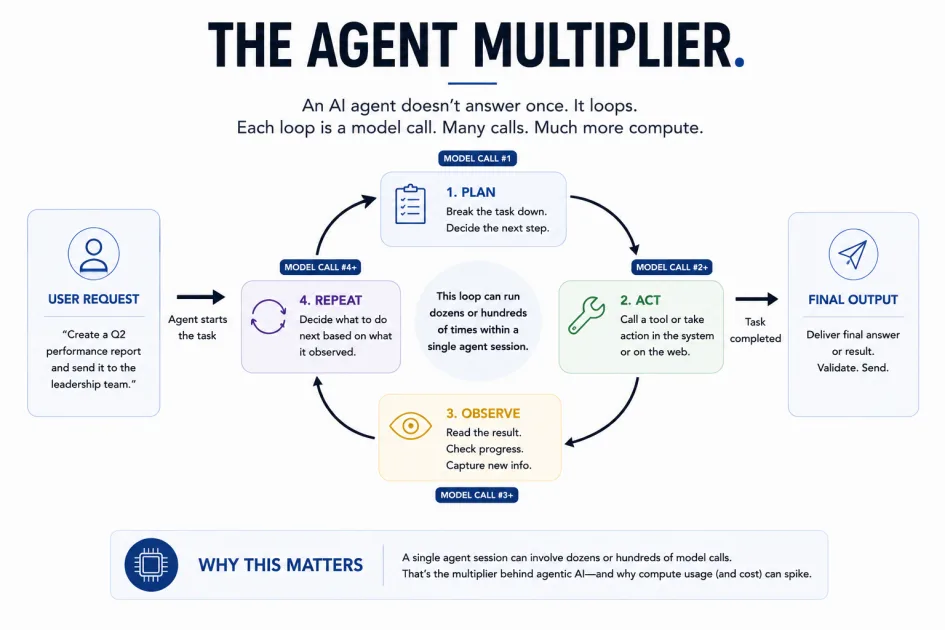
Ora, il risultato è un'altra cosa. Un agente AI non risponde una volta sola. Esegue dei cicli. Legge il compito, pianifica, chiama uno strumento, legge il risultato, decide cosa fare dopo, chiama un altro strumento, controlla l'output, scrive una risposta e convalida la risposta. Ogni fase è una chiamata al modello. Ogni chiamata al modello consuma calcolo.
Una singola sessione di agente può eseguire decine o centinaia di questi cicli. Questo è il motivo per cui gli agenti gestiti sono stati lanciati a 0,08 dollari per sessione-ora, oltre ai costi dei token, e perché le vostre bollette appaiono improvvisamente diverse nel momento in cui passate dalla chat all'automazione. Non siete passati da una domanda a dieci. Siete passati da una richiesta a diverse centinaia.
La svolta agenziale di cui tutti sono entusiasti è anche la svolta informatica. Sono la stessa tendenza.
Il calcolo come rischio aziendale, non solo come costo
Qui si smette di essere astratti. Il calcolo è limitato a livello di fornitori. Ci sono solo un numero limitato di acceleratori di fascia alta nel mondo, e sono tutti occupati. Quando la domanda aumenta (il lancio di un prodotto virale, un trimestre impegnativo, un nuovo modello popolare), il vostro fornitore ha tre opzioni: strozzarvi, mettervi in coda o farvi pagare di più.
L'avete già provato se avete notato che i limiti di utilizzo si restringono nelle ore di punta, o se avete visto il vostro modello preferito contrassegnato come "ad alta richiesta", o se avete visto comparire quote di sessione dove prima non esistevano. Niente di tutto questo è malizioso. Si tratta di gestione della capacità.
Per un'azienda che ha costruito flussi di lavoro intorno all'intelligenza artificiale, questa è una domanda di approvvigionamento, non una curiosità. Quali sono i limiti di throughput garantiti? Qual è lo SLA quando la capacità è limitata? Potete ripiegare automaticamente su un modello o un fornitore diverso? Se il vostro agente di assistenza clienti dipende da un modello che entra in modalità "alta domanda" ogni venerdì pomeriggio, avete un problema operativo reale, non ipotetico.
La questione strategica: dove deve risiedere l'elaborazione?
Questa è la domanda a cui ogni azienda dovrà rispondere. I modelli di frontiera del cloud sono i più efficienti, ma mettono il vostro calcolo sull'hardware di qualcun altro, soggetto ai suoi prezzi, alla sua capacità e, in molti casi, alla sua gestione dei dati. I modelli open-weight eseguibili localmente (Llama, Mistral, Qwen, DeepSeek, Gemma) mettono l'elaborazione su hardware controllato dall'utente, con costi prevedibili e senza l'intervento di terzi, ma si collocano un passo indietro rispetto ai modelli di frontiera in termini di capacità grezza.
Per alcuni flussi di lavoro, la frontiera è importante. Per altri, invece, non ha alcuna importanza. Un modello che classifica le e-mail in entrata, redige i dati personali, redige le risposte di routine o estrae informazioni strutturate dai documenti non deve essere la cosa più intelligente del mondo. Deve essere affidabile, prevedibile e vostro.
La risposta giusta raramente è "tutto cloud" o "tutto locale". Si tratta di un mix, deciso in base al flusso di lavoro.
Dove si va a parare
Ecco la previsione che dovrebbe orientare il vostro pensiero a tre anni.
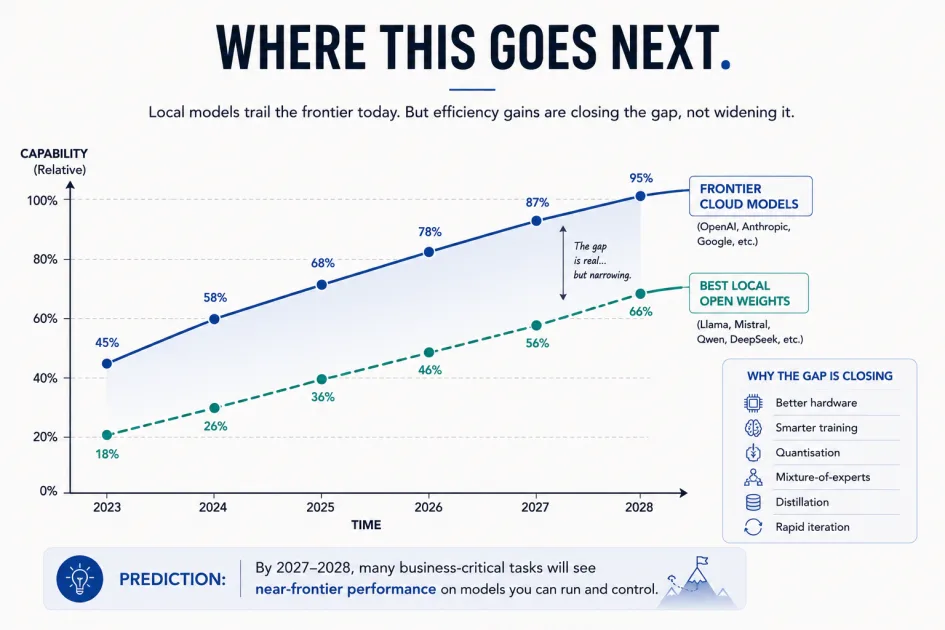
Diverse tecniche di efficienza si stanno accumulando contemporaneamente. La quantizzazione, che comprime i pesi del modello in formati a bassa precisione, ha già permesso a modelli che prima richiedevano 70 GB di memoria di funzionare utilmente con 20 GB, con una perdita di capacità trascurabile. L'addestramento consapevole della quantizzazione, in cui i modelli vengono istruiti fin dall'inizio a operare in bassa precisione, sta colmando il divario rimanente. Le architetture Mixture-of-experts attivano solo una frazione dei pesi del modello per ogni token, riducendo il calcolo per query senza ridurre la capacità. La distillazione sta producendo modelli di piccole dimensioni sorprendentemente capaci (Phi, Gemma 3, l'ultima linea Qwen) che superano di gran lunga il numero dei loro parametri. Il silicio specifico per l'inferenza (ad esempio, le NPU nei computer portatili, il Neural Engine di Apple e i chip Snapdragon X) rende l'inferenza locale molto più veloce sull'hardware di consumo. Ognuno di questi elementi rappresenta una leva di efficienza significativa. Insieme, stanno modificando ciò che è possibile fare senza un centro dati.
La versione onesta della previsione è la seguente. I pesi aperti eseguibili localmente di oggi sono all'incirca equivalenti alla frontiera dell'anno scorso, e questo divario probabilmente rimarrà aperto perché anche la frontiera si sta spostando. Ma "la frontiera dell'anno scorso, in esecuzione sul mio portatile" si rivela più che sufficiente per una buona parte di ciò che le aziende hanno bisogno di fare con l'intelligenza artificiale. Entro due o tre anni, la maggior parte dei flussi di lavoro dell'IA per le PMI sarà servita da configurazioni locali o ibride, anche se i modelli cloud di frontiera continueranno a progredire per i problemi più difficili.
Una dipendenza su cui vale la pena riflettere: i pesi aperti capaci esistono perché qualcuno (Meta, Mistral, Alibaba, DeepSeek) ha speso centinaia di milioni per addestrarli e ha scelto di rilasciarli. La traiettoria di sviluppo che sto descrivendo presuppone che questo modello continui. In caso contrario, gli utenti locali rimarranno bloccati su un'istantanea e i modelli "economici" scompariranno.
Lo strato geopolitico
Facciamo una breve deviazione. Il calcolo è ora un input per la sicurezza nazionale. Gli Stati Uniti hanno inasprito i controlli sulle esportazioni di chip avanzati. La Cina sta costruendo il proprio stack. L'Europa sta correndo per assicurarsi capacità che al momento non ha. Gli hyperscaler stanno spendendo centinaia di miliardi per i data center e diversi governi hanno dato il loro assenso a costruzioni da centinaia di miliardi di dollari.
Per una PMI, l'esposizione pratica è regionale. L'elaborazione del vostro fornitore potrebbe trovarsi in un luogo in cui vigono leggi diverse sui dati, una diversa stabilità politica e diverse garanzie di affidabilità. Per quanto riguarda la posizione fisica dell'elaboratore, i problemi di sovranità e le considerazioni transfrontaliere sono sempre più spesso questioni di approvvigionamento. L'argomento merita un post a sé stante, e ne avrà uno.
Cosa fare con tutto questo
Quattro spunti pratici per il resto dell'anno.
-
**Modelli di ragionamento per problemi veramente difficili. Modelli veloci per tutto il resto. Il giusto mix consente di risparmiare denaro reale su qualsiasi scala.
-
**Se state sperimentando flussi di lavoro agenziali, ipotizzate che ogni attività significativa costi da dieci a cento volte il costo di una singola query. Inseritelo nel vostro business case prima di scalare.
-
**Chiedete al vostro fornitore di IA quali sono le garanzie di throughput, cosa succede nei picchi di carico e quali sono le opzioni di ripiego. Se la risposta è vaga, si tratta di informazioni.
-
**Scegliete un flusso di lavoro per il quale la privacy, la prevedibilità o il costo sono più importanti della capacità grezza e provatelo su un modello di peso aperto che gira su un hardware di cui avete il controllo. Imparerete di più da un solo weekend di lavoro che da tutti gli articoli sull'argomento, compreso questo.
Il calcolo è la risorsa che dà forma a tutte le decisioni sull'intelligenza artificiale che vengono prese in questo momento, dai limiti di utilizzo settimanali alla geopolitica da mille miliardi di dollari di dove vengono prodotti i chip e chi li ottiene. Comprenderlo non significa essere un tecnologo. Vi rende un acquirente migliore.
**Qual è il flusso di lavoro nella vostra azienda in cui l'abbinamento di un modello a un compito farebbe la differenza?
Tradotto con DeepL.
Vuoi applicare queste idee alla tua azienda?
Se questo articolo ha sollevato una domanda utile, parliamo di dove AI, automazione o strategia di prodotto possono creare leva concreta nella tua organizzazione.
Avvia la conversazione