18 May 2026
Warum in der KI-Branche alle über Datenverarbeitung sprechen und was dies für Ihr Unternehmen bedeutet
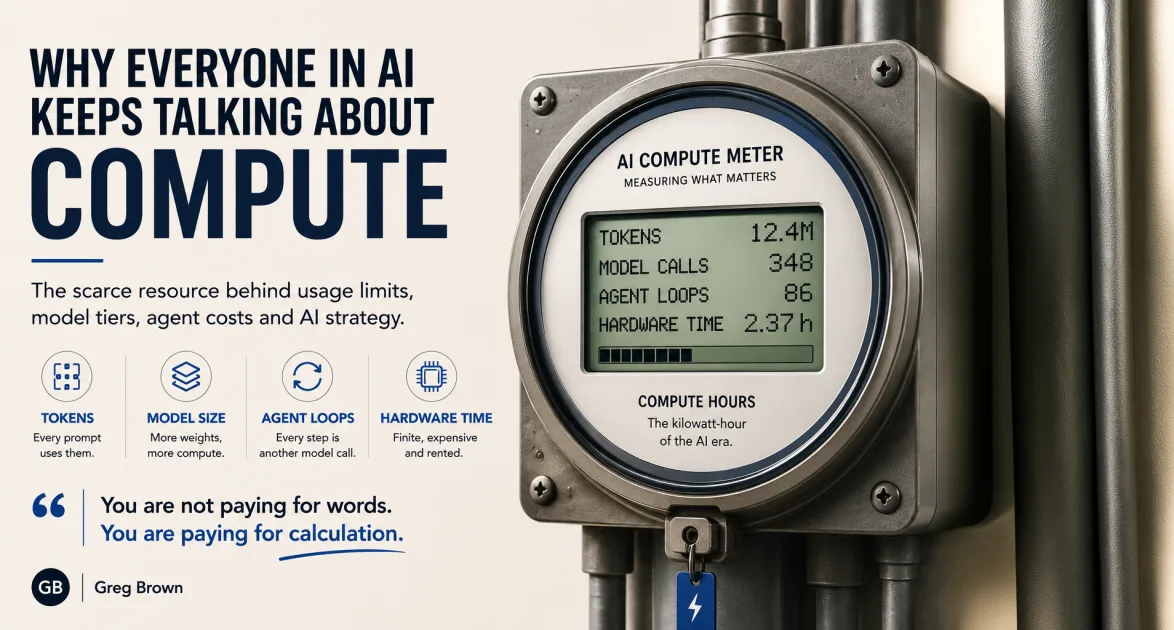
Verstehen Sie AI Compute: Warum Ihre Rechnung so funktioniert, wie sie funktioniert
Ihr Verbrauchslimit ist diesen Monat gesunken, und dann ist es vielleicht wieder gestiegen. Das Argumentationsmodell kostet fünfmal so viel wie das schnelle Modell. Verwaltete Agenten werden pro Sitzungsstunde und nicht pro Token abgerechnet. Das alles ist nicht willkürlich. Es läuft alles auf dasselbe hinaus: Rechenleistung.
Wenn Sie sich in den letzten zwei Jahren ein wenig mit künstlicher Intelligenz beschäftigt haben, haben Sie das Wort "Compute" in einer Weise gehört, die suggeriert, dass es alles erklärt. Das tut es auch fast. Wenn man einmal verstanden hat, wie die Ressource "Compute" funktioniert, ergibt eine Menge verwirrendes Marktverhalten plötzlich einen Sinn, darunter auch das meiste, was Sie bei Ihrer eigenen KI-Rechnung spüren.
Hier ist das Ganze im Klartext, und was es für die Entscheidungen bedeutet, die ein KMU-Eigentümer dieses Jahr treffen muss.
Was ist eigentlich "Compute"?
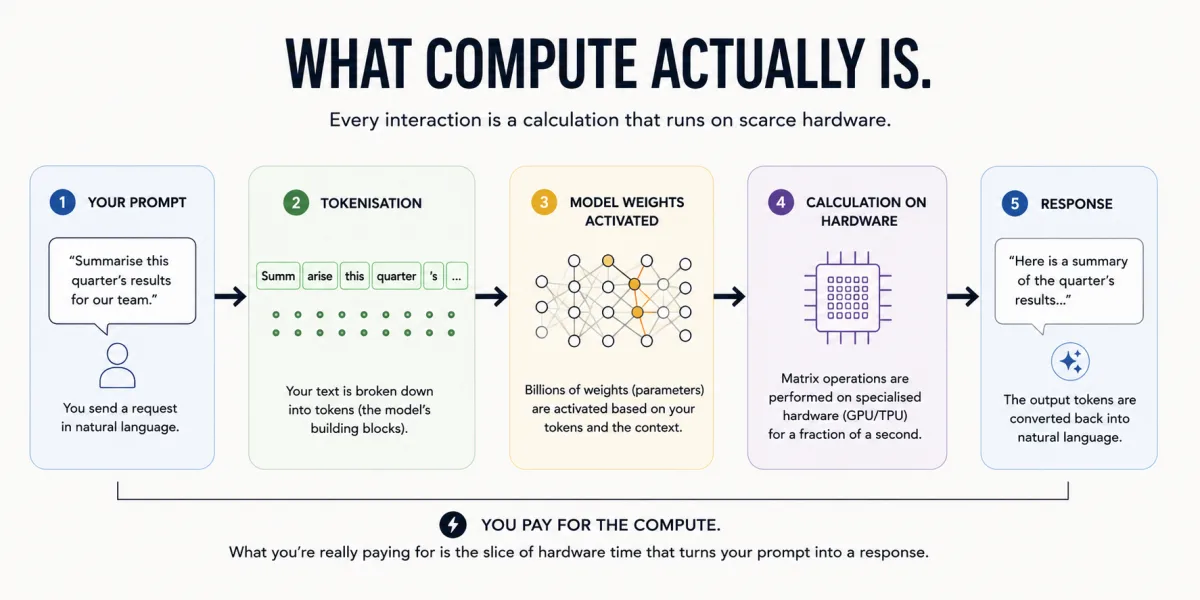
Jede Interaktion, die Sie mit einem KI-Modell haben, ist eine Berechnung. Eine sehr umfangreiche Berechnung, die Milliarden von Gewichten umfasst, wird auf spezieller Hardware durchgeführt, die für die Art von paralleler Mathematik optimiert ist, die neuronale Netze benötigen. Diese Hardware ist endlich, teuer und wird sekundenweise gemietet.
Ein Wort zu den Gewichten. Stellen Sie sich ein Modell als Milliarden winziger Drehknöpfe vor, von denen jeder während des Trainings so eingestellt wird, dass er das kodiert, was das Modell gelernt hat. Ein "70-Milliarden-Parameter"-Modell hat genau so viele Drehknöpfe. Jede Eingabeaufforderung durchläuft sie, weshalb größere Modelle mehr Rechenleistung erfordern.
Wenn Sie eine Eingabeaufforderung an Claude oder ChatGPT oder Gemini senden, zahlen Sie nicht wirklich für die Worte. Sie zahlen für den Teil der Rechenleistung, der Ihre Worte in eine Antwort umwandelt. Diese Rechenleistung wird über Token gemessen und abgerechnet, aber die zugrunde liegende knappe Ressource ist die Hardware-Zeit selbst.
Die nächstliegende Analogie zum Alltag ist Strom. Man bezahlt nicht dafür, "Licht zu haben". Man zahlt für die verbrauchten Kilowattstunden. Die Rechenleistung ist die Kilowattstunde der KI-Ära.
Warum kosten manche Abfragen viel mehr als andere?
Nicht alle Rechenleistung wird gleichmäßig verbraucht. Ein schnelles Modell, das eine E-Mail zusammenfasst, verbraucht nur einen kleinen Teil davon. Ein Rechenmodell, das ein mehrstufiges Problem bearbeitet, kann das Fünfzig- bis Hundertfache verbrauchen, da es zwischen der Eingabeaufforderung und der Antwort praktisch mit sich selbst spricht.
Aus diesem Grund gibt es bei allen großen Anbietern inzwischen verschiedene Stufen. Haiku, Sonnet, Opus. Flash, Pro. mini, standard, reasoning. Die billigen Modelle sind billig, weil sie entweder kleiner sind (weniger Gewichte zu berechnen) oder nur einen einzigen Durchlauf machen, bevor sie antworten. Die teuren Modelle denken, bevor sie sprechen, und Denken kostet Rechenzeit.
Die praktische Konsequenz ist die, auf die ich immer wieder zurückkomme: Verwenden Sie kein Argumentationsmodell, um eine Sitzungsnotiz zusammenzufassen. Sie zahlen den Preis eines Grenzmodells für die Arbeit mit einem schnellen Modell. Passen Sie das Modell an die Aufgabe an.
Der Agentenmultiplikator
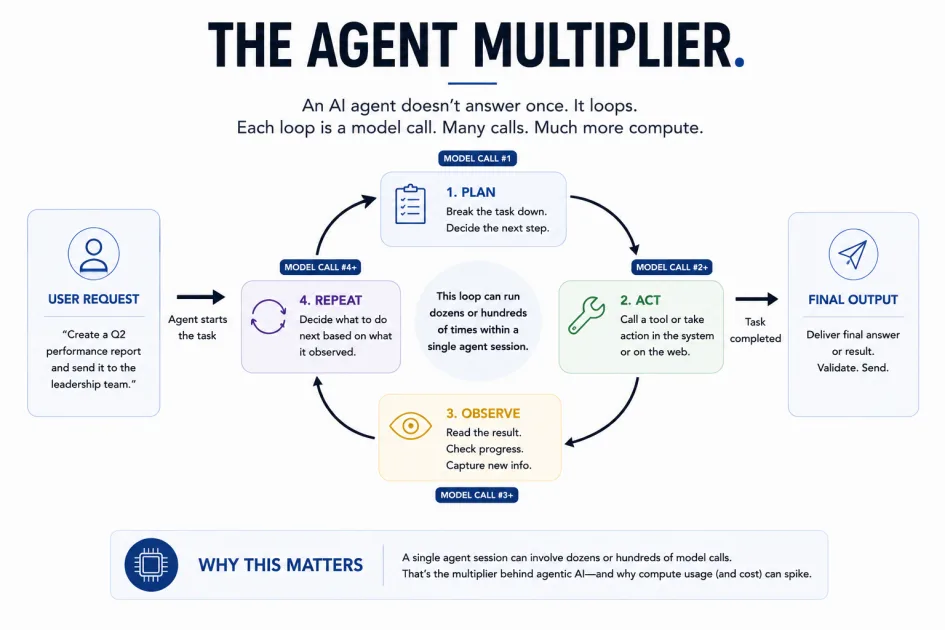
Jetzt vervielfachen Sie das. Ein KI-Agent antwortet nicht nur einmal. Er macht Schleifen. Er liest die Aufgabe, plant, ruft ein Tool auf, liest das Ergebnis, entscheidet, was als Nächstes zu tun ist, ruft ein weiteres Tool auf, überprüft die Ausgabe, schreibt eine Antwort und validiert die Antwort. Jeder Schritt ist ein Modellaufruf. Jeder Modellaufruf verbraucht Rechenleistung.
Eine einzige Agentensitzung kann Dutzende oder Hunderte dieser Schleifen durchlaufen. Das ist der Grund, warum Managed Agents mit 0,08 US-Dollar pro Sitzungsstunde zusätzlich zu den Token-Kosten gestartet sind und warum Ihre Rechnungen plötzlich anders aussehen, sobald Sie von Chat auf Automatisierung umstellen. Sie sind nicht von einer Anfrage zu zehn übergegangen. Sie sind von einer Anfrage zu mehreren hundert übergegangen.
Der Agentenwandel, über den sich alle freuen, ist auch der Computerwandel. Es ist derselbe Trend.
Compute als Geschäftsrisiko, nicht nur als Kostenfaktor
An dieser Stelle hört es auf, abstrakt zu sein. Die Rechenleistung ist auf Anbieterebene endlich. Es gibt nur eine bestimmte Anzahl von High-End-Beschleunigern auf der Welt, und sie sind alle vergeben. Wenn die Nachfrage in die Höhe schnellt (eine virale Produkteinführung, ein umsatzstarkes Quartal, ein beliebtes neues Modell), hat Ihr Anbieter drei Möglichkeiten: Er kann Sie drosseln, in eine Warteschlange stellen oder mehr verlangen.
Sie haben dies bereits zu spüren bekommen, wenn Sie bemerkt haben, dass die Nutzungsbeschränkungen zu Spitzenzeiten verschärft wurden, Ihr Lieblingsmodell als "stark nachgefragt" markiert wurde oder Sitzungsquoten dort auftauchten, wo es sie vorher nicht gab. Nichts davon ist böswillig. Es ist Kapazitätsmanagement.
Für ein Unternehmen, das Arbeitsabläufe rund um KI aufgebaut hat, ist dies eine Beschaffungsfrage, keine Kuriosität. Was sind Ihre garantierten Durchsatzgrenzen? Wie lauten die SLA, wenn die Kapazität knapp ist? Können Sie automatisch auf ein anderes Modell oder einen anderen Anbieter zurückgreifen? Wenn Ihr Kundenbetreuer von einem Modell abhängt, das jeden Freitagnachmittag in den "High Demand"-Modus wechselt, haben Sie ein echtes operatives Problem, kein hypothetisches.
Die strategische Frage: Wo soll Ihre Datenverarbeitung untergebracht werden?
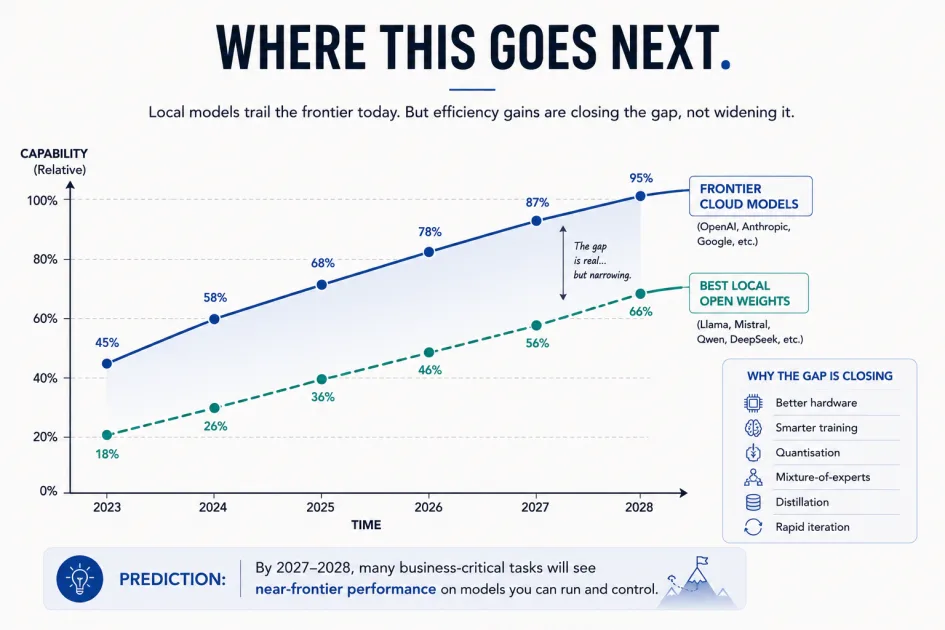
Diese Frage wird jedes Unternehmen irgendwann beantworten müssen. Cloud-Frontier-Modelle sind am leistungsfähigsten, aber sie stellen Ihre Rechenleistung auf die Hardware eines anderen Anbieters, dessen Preisgestaltung, Kapazität und in vielen Fällen auch dessen Datenverarbeitung unterliegt. Lokal betriebene Modelle mit offenem Gewicht (Llama, Mistral, Qwen, DeepSeek, Gemma) stellen die Rechenleistung auf Hardware bereit, die Sie kontrollieren, mit vorhersehbaren Kosten und ohne Dritte in der Schleife, aber sie liegen einen Schritt hinter den Frontier-Modellen, was die reine Leistungsfähigkeit angeht.
Für manche Arbeitsabläufe ist die Grenze wichtig. Für andere ist sie völlig unerheblich. Ein Modell, das eingehende E-Mails klassifiziert, personenbezogene Daten redigiert, Routineantworten verfasst oder strukturierte Informationen aus Dokumenten abruft, muss nicht unbedingt das intelligenteste Ding der Welt sein. Es muss zuverlässig und berechenbar sein und Ihnen gehören.
Die richtige Antwort lautet selten "nur Cloud" oder "nur lokal". Es ist eine Mischung, die je nach Arbeitsablauf entschieden wird.
Wie es weitergeht
Hier ist die Vorhersage, die Ihre Überlegungen für die nächsten drei Jahre bestimmen sollte.
Mehrere Effizienztechniken kommen gleichzeitig zum Einsatz. Die Quantisierung, bei der die Modellgewichte in Formate mit geringerer Genauigkeit komprimiert werden, hat bereits dazu geführt, dass Modelle, die früher 70 GB Speicherplatz benötigten, heute mit 20 GB Speicherplatz auskommen, und das bei vernachlässigbarem Verlust an Leistungsfähigkeit. Die verbleibende Lücke wird durch quantisierungsorientiertes Training geschlossen, bei dem den Modellen von Anfang an beigebracht wird, mit geringer Präzision zu arbeiten. Mixture-of-Experts-Architekturen aktivieren nur einen Bruchteil der Modellgewichte pro Token, wodurch der Rechenaufwand pro Abfrage ohne Leistungseinbußen reduziert wird. Die Destillation bringt überraschend leistungsfähige kleine Modelle hervor (Phi, Gemma 3, die neueste Qwen-Reihe), die weit über ihre Parameterzahl hinausgehen. Inferenzspezifisches Silizium (z. B. NPUs in Laptops, Apples Neural Engine und Snapdragon X-Chips) macht lokale Inferenzen auf Consumer-Hardware dramatisch schneller. Jeder dieser Faktoren ist ein bedeutender Effizienzhebel. Zusammen verändern sie die Möglichkeiten, die ohne ein Rechenzentrum möglich sind.
Die ehrliche Version der Vorhersage lautet wie folgt. Die heutigen lokal ausführbaren offenen Gewichte entsprechen in etwa der Grenze vom letzten Jahr, und diese Lücke wird wahrscheinlich offen bleiben, weil sich auch die Grenze bewegt. Aber die "Grenze vom letzten Jahr, die auf meinem Laptop läuft", wird für einen großen Teil der Aufgaben, für die Unternehmen tatsächlich KI benötigen, mehr als ausreichend sein. In zwei bis drei Jahren werden die meisten KI-Workflows für KMUs von lokalen oder hybriden Systemen bedient werden, auch wenn die Cloud-Modelle für die schwierigeren Probleme weiter auf dem Vormarsch sind.
Eine Abhängigkeit, über die es sich lohnt nachzudenken: Fähige Open Weights existieren, weil jemand (Meta, Mistral, Alibaba, DeepSeek) Hunderte von Millionen für ihr Training ausgegeben und sich entschieden hat, sie zu veröffentlichen. Der von mir beschriebene Entwicklungspfad setzt voraus, dass sich dieses Muster fortsetzt. Wenn dies nicht der Fall ist, werden die lokalen Nutzer auf einer Momentaufnahme sitzen bleiben, und "billige" Modelle werden verschwinden.
Die geopolitische Ebene
Lassen Sie uns einen kurzen Umweg machen. Die Datenverarbeitung ist heute ein Faktor der nationalen Sicherheit. Die USA haben die Exportkontrollen für moderne Chips verschärft. China baut seinen eigenen Stack auf. Europa bemüht sich um die Sicherung von Kapazitäten, die es derzeit nicht hat. Die Hyperscaler geben Hunderte von Milliarden für Rechenzentren aus, und mehrere Regierungen haben den Ausbau von Rechenzentren im Wert von mehreren Hundert Milliarden Dollar genehmigt.
Für ein KMU ist das Risiko in der Praxis regional. Die Rechenleistung Ihres Anbieters kann sich an einem Ort befinden, an dem andere Datengesetze, eine andere politische Stabilität und andere Zuverlässigkeitsgarantien gelten. Unabhängig davon, wo sich die Datenverarbeitung befindet, sind Fragen der Souveränität und grenzüberschreitende Überlegungen zunehmend ein Thema bei der Beschaffung. Das Thema verdient einen eigenen Beitrag und wird auch einen bekommen.
Was man mit all dem tun kann
Vier praktische Ratschläge für den Rest des Jahres.
-
Anpassen des Modells an die Aufgabe Reasoning-Modelle für wirklich schwierige Probleme. Schnelle Modelle für alles andere. Die richtige Mischung spart echtes Geld in jeder Größenordnung.
-
Budgetieren Sie für Agenten anders. Wenn Sie agentengestützte Arbeitsabläufe testen, gehen Sie davon aus, dass jede sinnvolle Aufgabe das Zehn- bis Hundertfache dessen kostet, was eine einmalige Abfrage kostet. Berücksichtigen Sie das in Ihrem Business Case, bevor Sie skalieren.
-
Behandeln Sie die Kapazität als eine Frage der Beschaffung Fragen Sie Ihren KI-Anbieter, wie Ihre Durchsatzgarantien aussehen, was bei Spitzenlast passiert und welche Ausweichmöglichkeiten Sie haben. Wenn die Antwort vage ausfällt, ist das eine Information.
-
**Wählen Sie einen Arbeitsablauf, bei dem der Datenschutz, die Vorhersagbarkeit oder die Kosten wichtiger sind als die reine Leistungsfähigkeit, und testen Sie ihn mit einem Modell mit offenem Gewicht, das auf der von Ihnen kontrollierten Hardware läuft. Sie werden an einem Wochenende mehr lernen als aus einer Vielzahl von Artikeln zu diesem Thema, einschließlich dieses Artikels.
Rechenleistung ist die Ressource, die derzeit jede KI-Entscheidung beeinflusst, von der wöchentlichen Nutzungsgrenze bis hin zur Billionen-Dollar-Geopolitik, wo die Chips hergestellt werden und wer sie bekommt. Das zu verstehen, macht Sie nicht zum Technologen. Es macht Sie zu einem besseren Einkäufer.
Bei welchem Arbeitsablauf in Ihrem Unternehmen würde die Anpassung eines Modells an eine Aufgabe den größten Unterschied ausmachen?
Maschinell aus dem Englischen übersetzt via DeepL, mit manuellen Korrekturen.
Möchten Sie das auf Ihr Unternehmen anwenden?
Wenn dieser Beitrag eine gute Frage ausgelöst hat, sprechen wir darüber, wo KI, Automatisierung oder Produktstrategie in Ihrer Organisation praktischen Hebel schaffen können.
Gespräch starten